Conclusion
この記事の結論
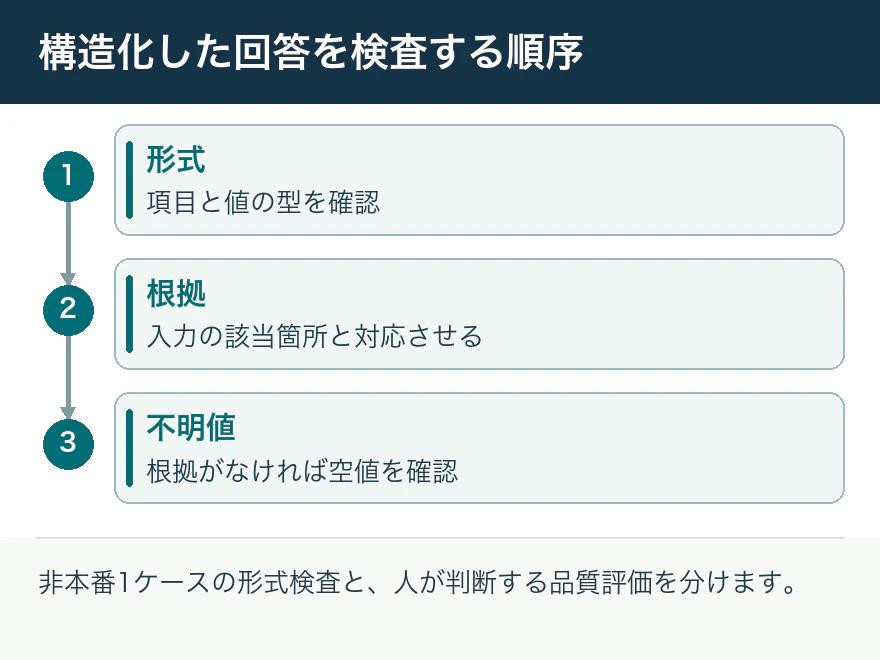
非本番の1ケースで、出力形式、根拠の参照、不明な項目の空値を確認しました。
生成AIに構造化した回答を求める場面では、「正しい形のJSONだった」という検査だけでは足りません。各回答がどの入力に基づくか、情報がないときに推測で埋めていないかを分けて試します。今回の試験では、非本番の1ケースで想定した出力の扱いを確認しました。
今回の対応
10月12日、非本番環境でAmazon BedrockのAmazon Novaを使い、1件の入力で出力を検証しました。形式が要件に合うこと、判断に対応する根拠の識別子があること、不明な項目が空値として返ることを確認しました。試験後は一時的な権限を撤去しました。
形式・参照・意味は別の検査
例えば受付日が入力で示されていない場合、もっともらしい日付を出すより、その欄を空値にした方が後工程は正しく判断できます。また、根拠の識別子が形式上存在していても、参照した箇所が実際に答えを支えるかは別問題です。機械で検査する項目と人が読む項目を分けて設計します。
状況別の判断と次の対応
| 観察した状態 | そこから判断できること | 次に確認すること |
|---|---|---|
| 項目名と型が合う | 後工程が構造を読み取れる | 想定する必須項目・空値の扱いを確認する |
| 根拠の識別子が存在 | 回答と入力を結び付けられる | 参照先が入力にあり意味が合うかを点検する |
| 不明値が空で返る | 少なくとも当該ケースでは補完していない | 別の入力でも同じ判断ができるか評価する |
次の品質評価で増やすケース
根拠が一つだけある例、複数の資料が食い違う例、答えのない例を分けて評価すると、形式上の成功が判断の誤りを隠しにくくなります。10月12日の試験後は一時権限を撤去しました。1件の成功を本番採用や業務品質の合格としては扱いません。
- 01入力例と期待する空値を決める
- 02形式と根拠の参照を照合する
- 03意味の妥当性を別ケースで評価する
確認結果で判断期待どおり → 結果を記録して完了期待と異なる → 止まった手順と結果を整理し、担当者へ確認